Fenómeno de confusión ¿Cúal es su importancia al interpretar la evidencia?

Nut. Diego Torres

Tiempo de lectura: 8 minutos
Introducción
1. Cuando una asociación puede ser engañosa
Imagina que trabajas en una tienda y, después de años atendiendo clientes, notas que las personas que compran más protector solar también parecen tener más quemaduras en la piel.
¿Significa esto que el protector solar aumenta el riesgo de quemarse?
No necesariamente. Las personas que compran más protector solar probablemente pasan más tiempo bajo el sol, y es la exposición al sol la que aumenta el riesgo de sufrir quemaduras.
En este caso, la exposición al sol actuaría como un factor de confusión: está relacionada tanto con la compra de protector solar como con las quemaduras en la piel (Figura 1).
Figura 1. Mecanismo de actuación de un factor de confusión
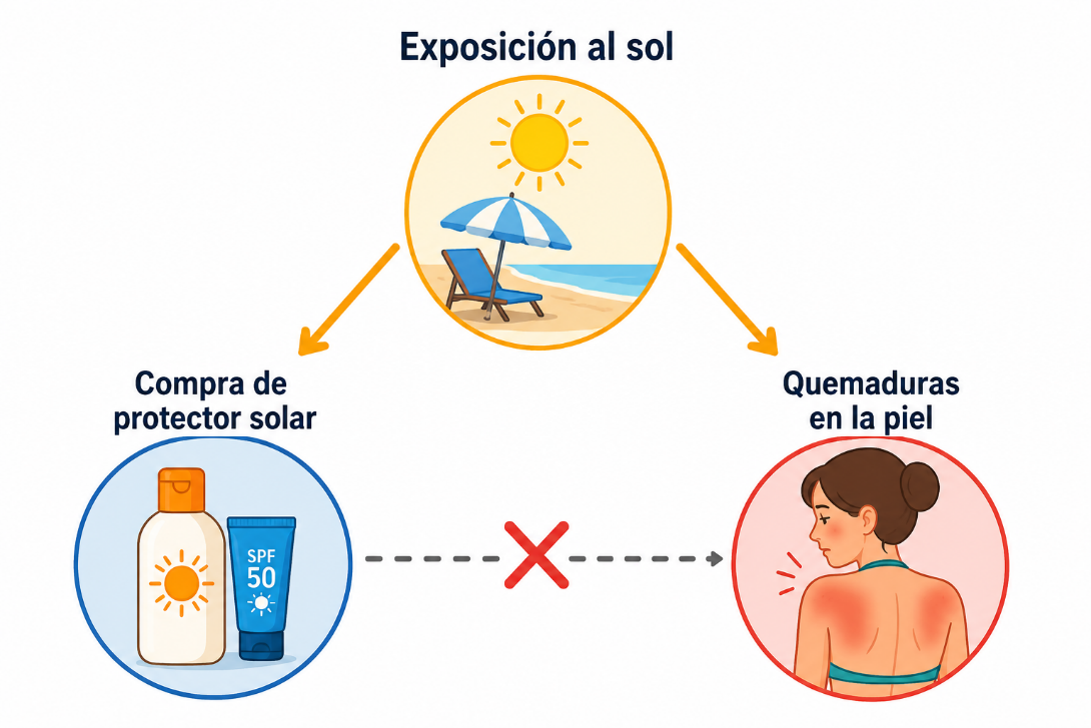
Atribuir al protector solar un mayor riesgo de quemaduras nos llevaría a interpretar de manera incorrecta la asociación observada, cuando esta podría explicarse por una mayor exposición al sol.
Y esto es precisamente uno de los problemas a los que se enfrenta con frecuencia la epidemiología y, en particular, la investigación observacional: determinar si la asociación que observamos se debe realmente a la exposición estudiada o si puede explicarse, al menos en parte, por otras variables.
Por esta razón, durante el diseño del estudio se debe considerar qué variables podrían actuar como factores de confusión y, cuando sea posible, recopilar información sobre ellas para poder controlarlas posteriormente.
En este artículo veremos cómo los factores de confusión pueden generar o modificar asociaciones entre variables, cómo se identifican y qué estrategias se utilizan para controlarlos en la investigación científica.
2. ¿Qué es un factor de confusión?
Una vez que entendemos que una asociación puede estar influida por otras variables, podemos preguntarnos: ¿qué características debe tener una variable para considerarla un factor de confusión?
En términos generales, hablamos de confusión cuando una tercera variable está relacionada tanto con la exposición que estamos estudiando como con el resultado, y su presencia puede distorsionar la asociación que observamos entre ambos (Figura 1).
La confusión puede:
Magnificar una asociación, haciendo que parezca más fuerte de lo que realmente es.
Atenuar una asociación, haciendo que parezca más débil de lo que realmente es.
Generar una asociación aparente, cuando en realidad no existe una relación entre la exposición y el resultado.
Invertir la dirección de una asociación, haciendo que parezca protectora cuando en realidad podría ser perjudicial, o viceversa.
3. ¿Cómo podemos identificar los factores de confusión?
Identificar los posibles factores de confusión no consiste simplemente en buscar variables que estén relacionadas estadísticamente con la exposición y el resultado. Necesitamos apoyarnos en el conocimiento previo y en el razonamiento sobre cómo podrían relacionarse las variables entre sí.
Por ejemplo, si queremos estudiar la relación entre una determinada exposición y una enfermedad cardiovascular, variables como la edad, el tabaquismo, la actividad física o el nivel socioeconómico podrían ser consideradas posibles factores de confusión si existen razones para pensar que están relacionadas tanto con la exposición como con el riesgo de enfermedad.
Por esta razón, no deberíamos seleccionar los factores de confusión únicamente porque hayan mostrado una asociación estadística en nuestro estudio. Una variable puede ser relevante aunque la asociación no sea evidente en nuestra muestra, y una variable estadísticamente asociada no necesariamente es un confusor.
Para ayudarnos a representar y evaluar estas relaciones también podemos utilizar diagramas causales, conocidos como DAGs (Directed Acyclic Graphs). Estas herramientas permiten representar gráficamente cómo podrían relacionarse las diferentes variables y ayudan a decidir cuáles deberían considerarse en el análisis.
Sin embargo, no todas las variables que forman parte de estas relaciones cumplen la misma función. Por eso, es importante distinguir entre confusores, mediadores y colisionadores.
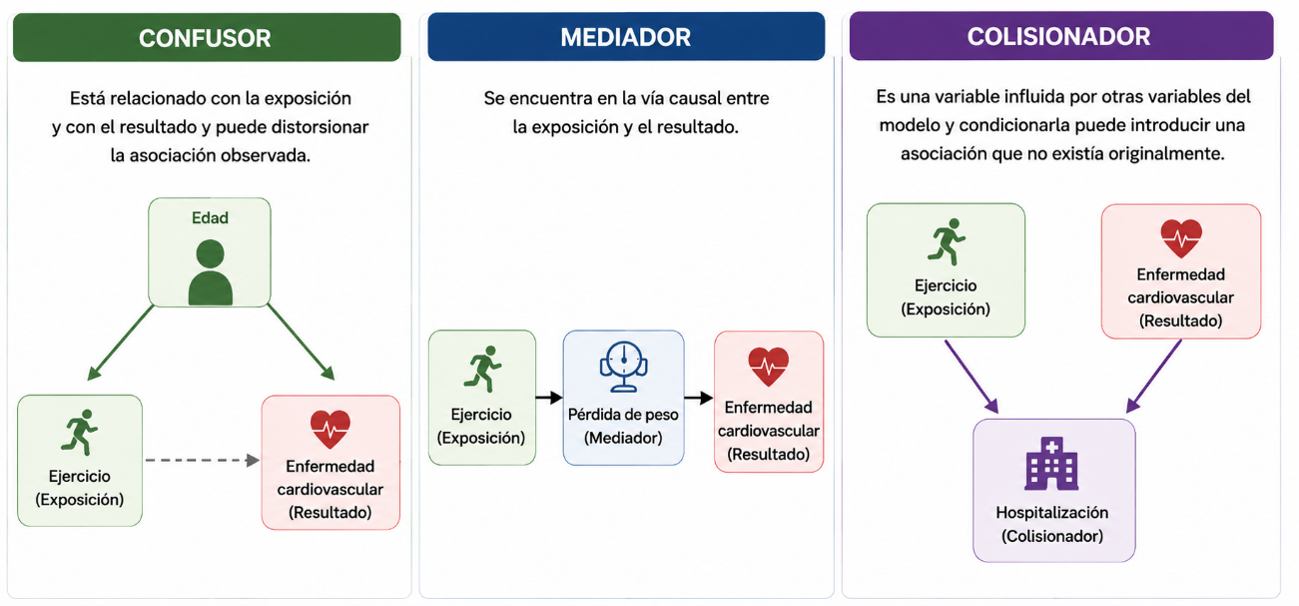
Confusor, mediador y colisionador: ¿en qué se diferencian?
Confusor:
está relacionado con la exposición y con el resultado y puede distorsionar la asociación observada.
Mediador:
se encuentra en la vía causal entre la exposición y el resultado.
Colisionador:
es una variable influida por otras variables y que, al seleccionarla o ajustarla, puede crear una asociación que en realidad no existía.
Ejemplo en figura 2.
Figura 2. Diferencias entre confusor, mediador y colisionador
4. ¿En qué tipo de estudios podemos encontrar un factor de confusión?
El fenómeno de confusión es un problema propio de los estudios observacionales, donde los investigadores no asignan directamente la exposición a los participantes. Por ello, las personas que están expuestas y las que no lo están pueden presentar otras características diferentes entre sí que también influyen sobre el resultado. Cuando una de estas características se relaciona tanto con la exposición como con el resultado, puede distorsionar la relación que estamos estudiando y hacer que parezca que existe una asociación diferente a la real.
En los estudios experimentales, la aleatorización busca que la asignación de los participantes a los grupos sea determinada por el azar. De esta manera, los factores de confusión no determinan a qué grupo pertenece cada participante, sino que su distribución entre los grupos queda sujeta al azar. Por ello, cuando la aleatorización se realiza correctamente, las diferencias que puedan observarse entre los grupos se consideran parte del error aleatorio y no un fenómeno de confusión.
5. ¿Cómo podemos controlar la confusión?
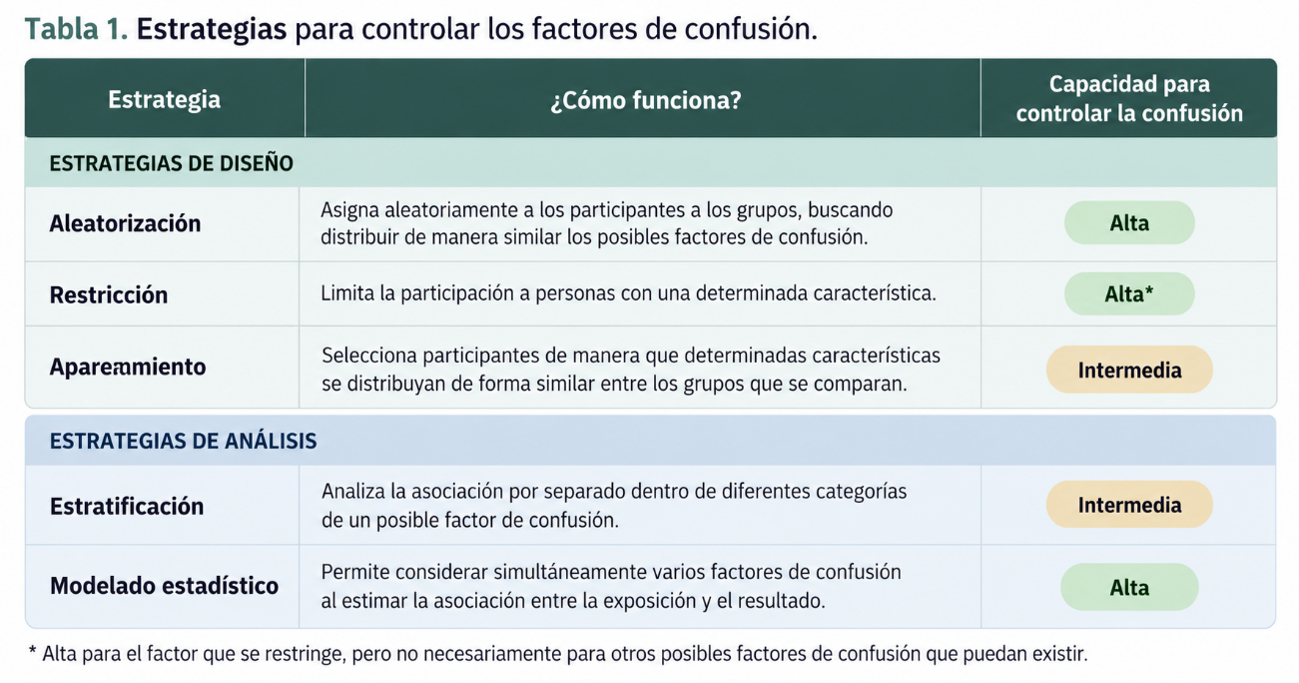
En los estudios observacionales, una vez identificados los posibles factores de confusión, podemos utilizar diferentes estrategias para reducir su influencia sobre los resultados. Estas estrategias pueden aplicarse durante el diseño del estudio o durante el análisis de los datos, como se resume en la Tabla 1.
Sin embargo, controlar la confusión no significa que podamos eliminarla por completo. Las estrategias utilizadas pueden controlar determinados factores, pero otros pueden no haber sido identificados, medidos o considerados en el análisis. Además, ajustar por una variable que no es un confusor puede introducir nuevas distorsiones en lugar de corregirlas.
6. ¿Podemos estar seguros de que no queda confusión?
No estamos completamente libres de confusión. Incluso cuando identificamos y controlamos los principales factores de confusión, puede persistir cierto grado de confusión residual debido a variables que no fueron medidas, a una medición imperfecta o a factores que desconocemos.
Esto es especialmente importante en los estudios observacionales, donde no podemos controlar todas las características de las personas que forman parte de los grupos que estamos comparando. Aunque ajustemos por variables como la edad, el tabaquismo, la actividad física o el nivel socioeconómico, podrían existir otros factores que influyan sobre la exposición y el resultado y que no hayamos considerado.
Además, incluso cuando una variable ha sido incluida en el estudio, una medición imperfecta puede hacer que el control de la confusión sea incompleto. Por ejemplo, si registramos la actividad física mediante una estimación poco precisa, el ajuste estadístico puede no eliminar por completo su influencia.
Por ello, la ausencia de confusión no puede darse por garantizada. Las estrategias de control nos permiten reducir las posibles distorsiones, pero no necesariamente eliminarlas por completo.
Nuestro objetivo no es alcanzar una evidencia perfecta, sino reducir al máximo las posibles fuentes de distorsión y tomar las mejores decisiones posibles a partir de la mejor evidencia disponible.
La ciencia no nos ofrece certezas absolutas; nos ofrece herramientas para reducir la incertidumbre y tomar mejores decisiones.
7. Recomendaciones prácticas
Identifica los posibles factores de confusión. Antes de aceptar una asociación como una relación causal, considera qué otras variables podrían estar relacionadas tanto con la exposición como con el resultado. Para ello, es útil apoyarse en la literatura científica, el conocimiento previo y el razonamiento causal.
Revisa qué variables fueron consideradas en el análisis. Observa qué posibles factores de confusión tuvieron en cuenta los investigadores y cómo los controlaron. Esto permite valorar si la asociación observada podría estar influida por otras variables.
Evalúa cómo se controló la confusión. Revisa qué estrategia utilizaron los investigadores para reducir su influencia y si esta parece adecuada para el estudio. Entre las estrategias que podemos encontrar están la restricción, el apareamiento, la estratificación y el modelado estadístico
Recuerda que el control no garantiza la ausencia de confusión. Incluso cuando se han considerado los principales factores conocidos, pueden existir variables que no fueron medidas, que fueron medidas de manera imperfecta o que todavía desconocemos. Por ello, puede persistir cierto grado de confusión residual.
Referencias:
Beaglehole, R., R. Bonita, and T. Kjellstrom. "Basic epidemiology." (No Title).
Greenhalgh, Trisha. How to read a paper. BMJ Books 2001, 2001.
Quispe, Antonio M., María Gracia Alvarez-Valdivia, and Silvana Loli-Guevara. "Metodologías Cuantitativas 2: Sesgo de confusión y cómo controlar un confusor." Revista del Cuerpo Médico Hospital Nacional Almanzor Aguinaga Asenjo 13.2 (2020): 205-212.
VanderWeele, Tyler J. "Principles of confounder selection: TJ VanderWeele." European journal of epidemiology 34.3 (2019): 211-219.